Qwen เปิดน้ำหนัก 3.8-Flash-Next: เลือกโมเดล AI ไม่ใช่แค่ดูตัวเลขครับ
สรุปสั้น
เวลาเห็นโมเดล AI ตัวใหม่ เรามักดูว่า "เก่งขึ้นแค่ไหน" แต่เรื่องจริงที่ต้องแข่งกันคือ ใครทำให้โมเดลใช้หน่วยความจำ การคำนวณ และบริบทยาวได้คุ้มแค่ไหน ว่าแต่ SME ต้องทดสอบงานจริงก่อนเลือกใช้ครับ
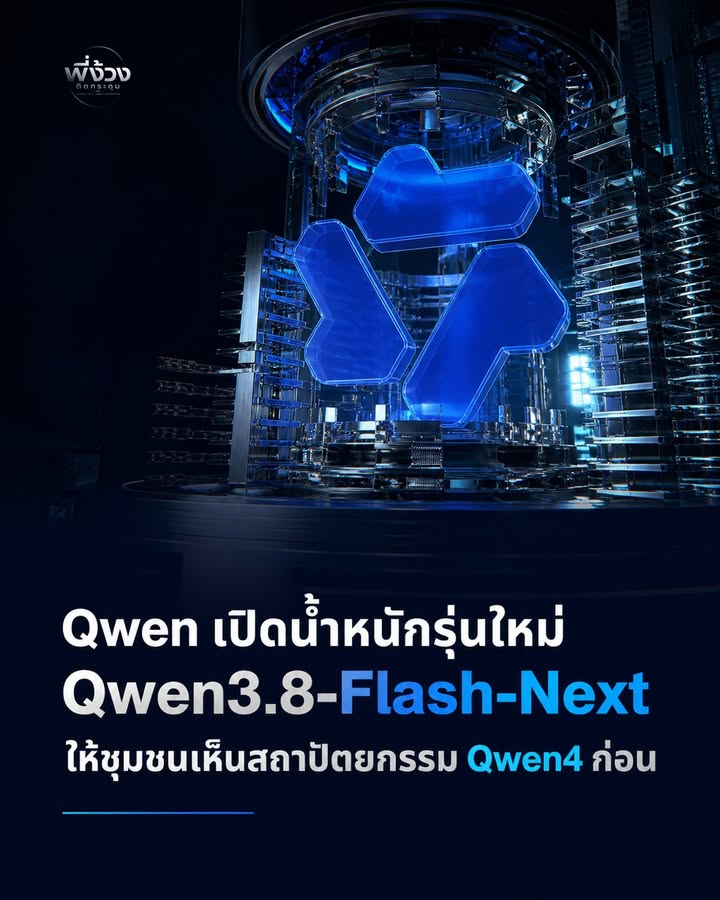
เวลาเห็นโมเดล AI ตัวใหม่ เรามักดูว่า "เก่งขึ้นแค่ไหน" ครับ
แต่ข่าวรอบนี้มีอีกมุมที่น่าสนใจกว่า
Qwen เปิดน้ำหนักโมเดลใหม่
วันที่ 26 สิงหาคม 2026 ทีม Qwen เปิดน้ำหนักของ Qwen3.8-Flash-Next ซึ่งเป็นโมเดล Multimodal แบบ Mixture-of-Experts
บอกตรง ๆ ว่านี่คือภาพตัวอย่างล่วงหน้าของสถาปัตยกรรมที่จะใช้กับ Qwen4
คำว่า "เปิดน้ำหนัก" สำคัญครับ
เพราะนักพัฒนาและนักวิจัยไม่ได้เห็นแค่ผลลัพธ์ปลายทาง แต่สามารถนำโมเดลไปทดลอง ตรวจสอบ และต่อยอดในสภาพแวดล้อมของตัวเองได้ตามเงื่อนไขการใช้งาน
สเปค และการออกแบบ
Qwen ระบุว่าโมเดลนี้มี:
- พารามิเตอร์หลัก 125 พันล้านตัว
- N-gram Embedding เพิ่มอีก 51 พันล้านตัว
- แต่เปิดใช้งานประมาณ 6 พันล้านพารามิเตอร์ต่อโทเคน
ทีมยังบอกด้วยว่า ออกแบบ Attention, Residual, Embedding และวิธีฝึกใหม่ เพื่อให้รับบริบทยาวและใช้ทรัพยากรคุ้มขึ้น
หมายเหตุ: ตัวเลขประสิทธิภาพทั้งหมดในบทความเป็นผลทดสอบที่ผู้พัฒนารายงานนะครับ ไม่ควรอ่านเป็นการรับรองว่าโมเดลจะเร็วกว่า ถูกกว่า หรือเหมาะกับงานของเราทุกกรณี
บทเรียนสำหรับธุรกิจ
การแข่งขัน AI ไม่ได้อยู่ที่ขนาดโมเดลอย่างเดียวแล้ว
คนทำระบบกำลังแข่งกันว่า จะทำให้โมเดลใช้หน่วยความจำ การคำนวณ และบริบทยาวได้คุ้มแค่ไหน
ถ้า SME กำลังเลือกโมเดลมาทำ Agent
อย่าเริ่มจากตารางคะแนนอย่างเดียวครับ 💪
ลองเอางานจริง 20–30 เคสของบริษัทมาทดสอบ ทั้ง:
- ความถูกต้องของผลลัพธ์
- การรองรับภาษาไทย
- เวลาในการตอบ
- ค่าใช้จ่าย
- จุดที่คนต้องเข้ามาตรวจสอบอยู่
เพราะโมเดลที่ "เก่งที่สุดในข่าว" อาจไม่ใช่โมเดลที่ "คุ้มที่สุดในระบบของเรา"
นี่คือบทเรียนของการติดกระดุมเม็ดแรก 🔥
ลุยกันครับ!
TL;DR
Qwen เปิดน้ำหนัก Qwen3.8-Flash-Next และระบุว่าเป็นตัวอย่างสถาปัตยกรรมก่อน Qwen4 บทเรียนสำหรับธุรกิจคือ อย่าดูแค่ขนาดหรือคะแนน ต้องทดสอบงานจริง ความแม่น เวลา และต้นทุนในระบบของเราครับ
Source: Qwen Team, "Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost-Efficiency," 26 Aug 2026. https://qwen.ai/blog?id=qwen3.8-flash-next
- #Qwen
- #AI Models
- #AI Architecture
- #Open Weight
- #AI Agent
- #Cost Efficiency
เรียนต่อกับพี่ง้วง
[ทดลองเรียน] คลาสสร้างกองทัพ Custom AI ด้วย ChatGPT
สร้างพนักงาน AI ประจำตำแหน่งในบริษัทของคุณ ตั้งแต่ Stage 3 ถึง Stage 6 ของบันได AI Maturity
บทความที่เกี่ยวข้อง
 AI
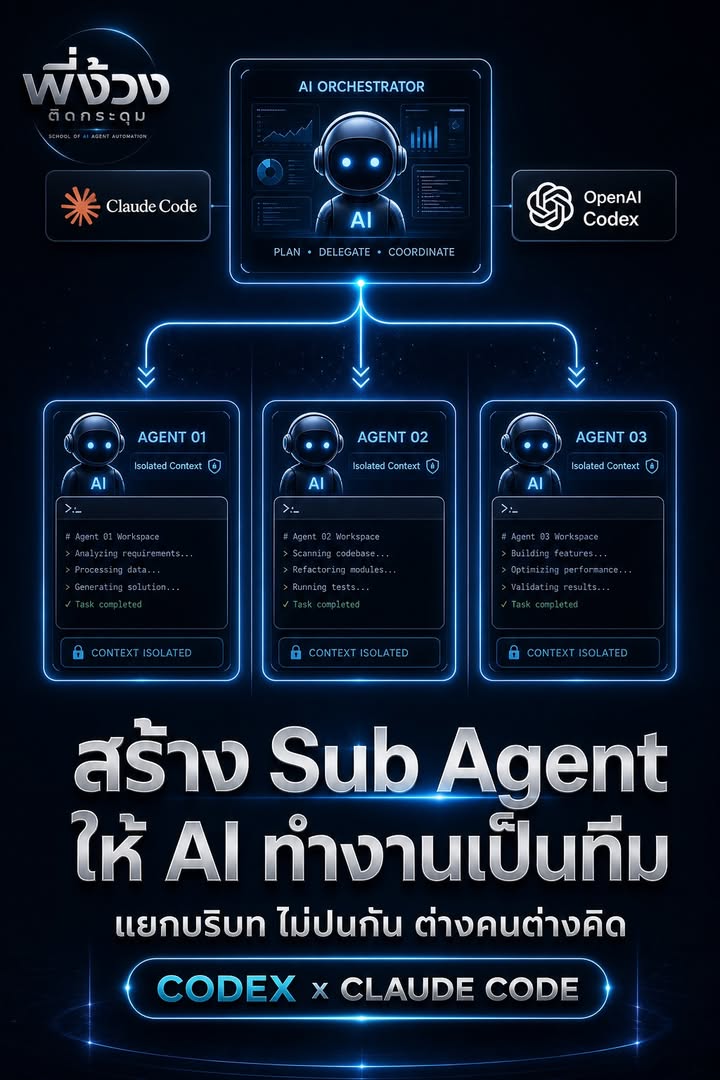
Sub Agent คืออะไร: ออกแบบทีม AI แทนใช้ AI ตัวเดียวทำทุกอย่าง
หลายคนใช้ AI Agent แบบให้ AI ตัวเดียวคิดทุกเรื่องในแชตเดียว ผลคือบริบทเริ่มปนกัน งานเขียนปนโค้ด รีเสิร์ชปนตัดสินใจ แล้ว AI จำผิด โฟกัสหลุด นี่คือเหตุผลที่ Sub Agent สำคัญ — การแยก AI ออกเป็นผู้ช่วยเฉพาะทางหลายตัว ไม่ใช่ AI ตัวเดียวทำทุกอย่าง
 AI
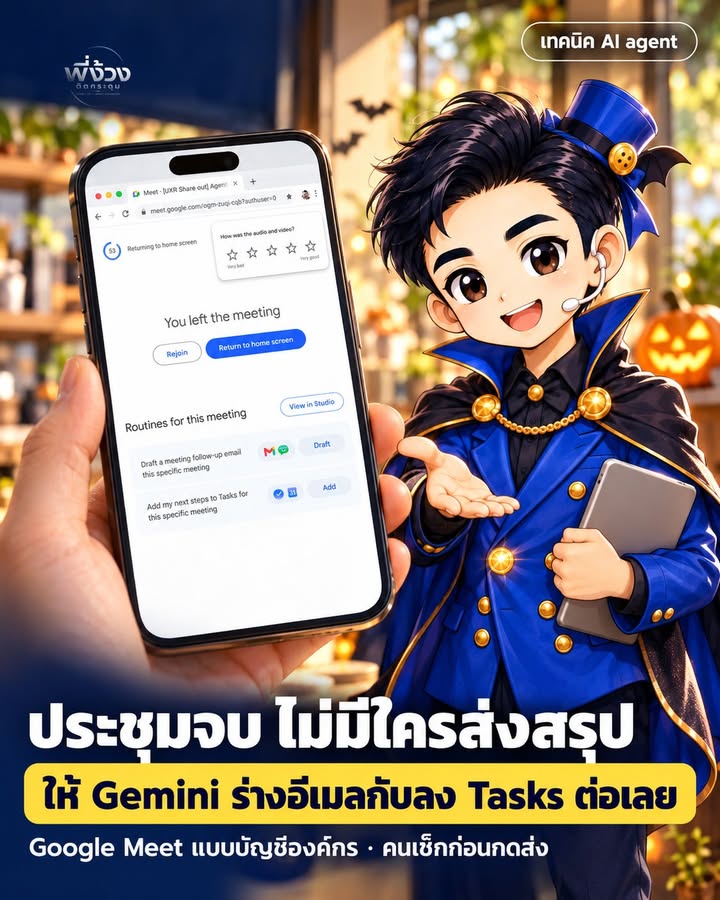
ให้ Gemini ทำสรุปประชุมให้ แล้วส่งโดยอัตโนมัติ — Routines ฟีเจอร์ใหม่บน Google Meet
Google Meet เปิดฟีเจอร์ Routines ใหม่ที่ให้ Gemini ร่างสรุปประชุมเป็นอีเมล และสร้างงานใน Google Tasks โดยอัตโนมัติ ตรวจแล้วกดส่งเถอะครับ
 AI
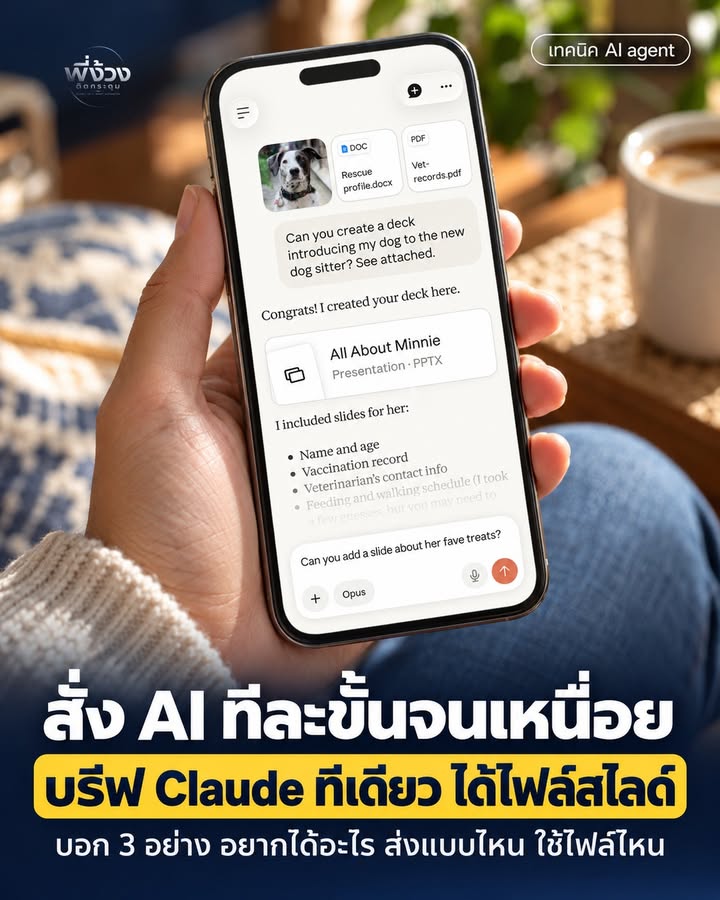
สั่ง Claude แบบบรีฟเพื่อนร่วมงาน ไม่ต้องทีละขั้น
Claude มี Cowork ฟีเจอร์ใหม่ที่เหมือนบรีฟเพื่อนร่วมงาน บอกผลจบที่อยากได้ รูปแบบ และไฟล์ที่ต้องใช้ แล้วมันไล่ทำเองทีละขั้น ค้นเว็บ อ่านไฟล์ รันโค้ด จนได้ผลลัพธ์คืนมา